Tech
내 코드는 CPU 코어를 몇 개 쓰고 있을까 — React, Node, Spring Boot, Python 직접 재보기
웹 개발을 하면서도 내 서버가 싱글코어로 도는지 멀티코어로 도는지, 스레드와 프로세스를 몇 개 쓰는지 몰라서 직접 측정해보며 공부한 기록
React, Node, Spring Boot로 개발을 하고 요즘은 Python도 공부하고 있다. 그런데 누가 “그 서버, 코어 몇 개 써요? 스레드는 몇 개 떠요?”라고 물으면 대답을 못 한다. “Node는 싱글 스레드”라는 말은 외우고 있지만 그게 실제로 코어를 하나만 쓴다는 뜻인지도 확실하지 않았다.
그래서 외운 말을 믿는 대신 직접 재보기로 했다. 공부하면서 쓰는 글이다.
측정 환경: Apple M5 맥북(성능 코어 4 + 효율 코어 6, 총 10코어), Node v26.13.0, Python 3.9.6, JDK 25(Temurin), Spring Boot 4.1.2
먼저 용어부터
- 코어: 실제로 명령어를 실행하는 하드웨어. 10코어면 동시에 10개의 흐름을 실행할 수 있다.
- 프로세스: 실행 중인 프로그램. 메모리 공간을 각자 따로 가진다.
- 스레드: 프로세스 안의 실행 흐름. 같은 프로세스의 스레드끼리는 메모리를 공유한다.
공부하면서 제일 먼저 바뀐 생각이 있다. 코드가 코어를 고르는 게 아니다. 내 코드는 스레드를 만들 뿐이고 어떤 스레드를 어느 코어에 올릴지는 OS 스케줄러가 정한다. 그러니 질문도 바뀌어야 한다.
“몇 번 코어를 쓰나?”가 아니라 “실행할 일이 있는 스레드가 동시에 몇 개인가?”
스레드 하나는 한순간에 코어 하나만 쓸 수 있다. 스레드가 코어 사이를 옮겨 다닐 수는 있어도 혼자서 두 코어를 동시에 쓰지는 못한다. 그래서 “멀티코어를 쓴다”는 건 일하는 스레드(또는 프로세스)가 동시에 여러 개라는 뜻이다. 스레드가 200개 떠 있어도 대부분 자고 있다면 코어는 거의 놀고 있다.
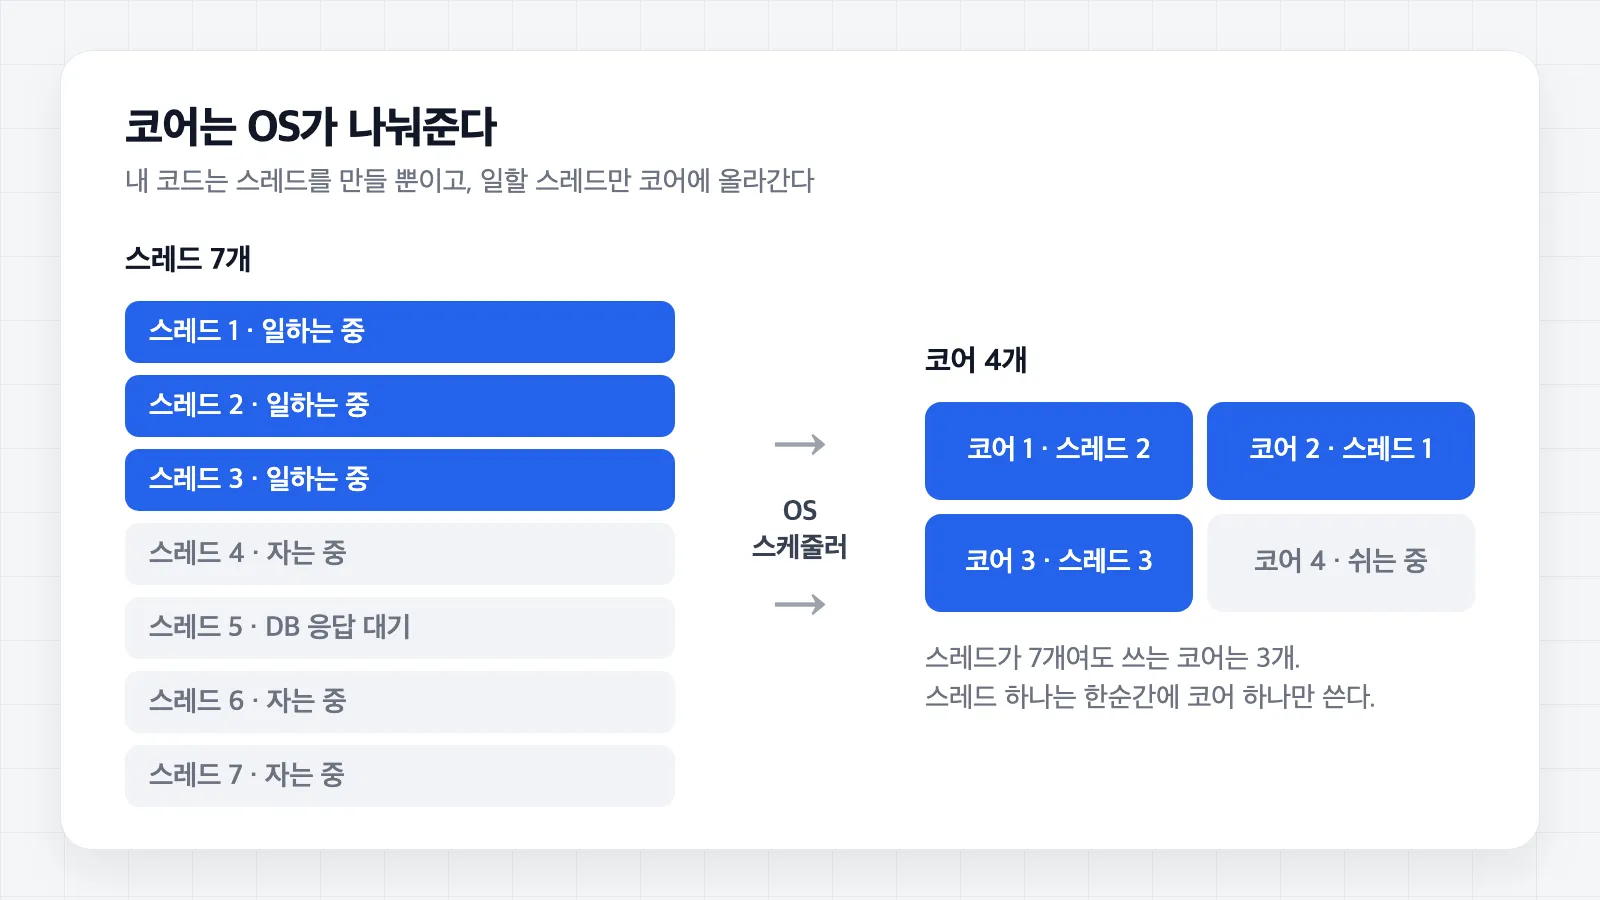 스레드 수와 쓰는 코어 수는 다르다(이해를 돕기 위한 예시)
어떻게 재나
# macOS: 프로세스의 스레드 목록
ps -M -p <PID>

# Linux: 스레드 수, 스레드별 CPU 사용량
ps -o nlwp= -p <PID>
top -H -p <PID>top이나 ps의 %CPU도 같이 보면 좋다. 100%가 코어 1개를 꽉 쓰는 것이고 400%면 코어 4개만큼 쓰고 있다.
쉬지 않고 CPU만 쓰는 작업이 필요해서 실험에는 일부러 비효율적인 재귀 피보나치를 썼다.
Node.js: 싱글 스레드라더니 7개?
아무것도 안 하는 Node 프로세스의 스레드를 세어봤다.
node -e "setInterval(()=>{},1000)" &
ps -M -p $!7개가 나왔다. macOS의 sample 명령으로 이름까지 확인할 수 있다.
| 스레드 | 개수 | 역할 |
|---|---|---|
| main | 1 | 내 JS를 실행하는 이벤트 루프 |
node-V8Worker | 4 | V8의 보조 작업(GC, 컴파일 등) |
DelayedTaskSchedulerWorker | 1 | V8 지연 작업 스케줄링 |
SignalInspector | 1 | 디버거(인스펙터) 시그널 처리 |
http 서버를 띄워도 7개 그대로였다. 요청을 받는다고 스레드가 늘어나지 않는다. (ESM 스크립트로 돌린 일부 실험에서는 9개로 찍혔는데 나머지 2개의 정체는 아직 못 밝혔다.)
즉 “Node는 싱글 스레드”를 정확히 말하면 내 JS 코드를 실행하는 스레드가 하나다.
그럼 정말 막히나
/block에서 fib(43)을 돌리는 서버를 띄우고 그동안 /ping을 보내봤다.
| 상황 | /ping 응답 시간 |
|---|---|
| 평상시 | 28ms |
/block 처리 중 | 1811ms |
처리 중 CPU는 98.7%, 코어 딱 하나만큼이었다. 10코어 중 9개가 놀고 있는데도 /ping은 아무 계산도 안 하면서 1.8초를 기다렸다. 메인 스레드 하나가 막히면 서버 전체가 멈춘다는 말을 숫자로 처음 봤다.
숨어있는 스레드 풀
그런데 모든 일을 메인 스레드가 하는 건 아니다. crypto.pbkdf2 8개를 동시에 돌리고 끝나는 시각을 찍어봤다.
crypto.pbkdf2('a', 'b', 600000, 64, 'sha512', callback);| 설정 | 각 작업이 끝난 시각(ms) | 전체 스레드 |
|---|---|---|
| 기본값 | 113, 114, 117, 118, 229, 229, 238, 256 | 11 |
UV_THREADPOOL_SIZE=8 | 134, 140, 153, 158, 161, 163, 164, 164 | 15 |
기본값에서는 4개씩 끊어서 끝난다. libuv의 스레드 풀 크기가 기본 4이기 때문이다. 스레드 수도 7 + 4 = 11, 7 + 8 = 15로 딱 맞아떨어진다. 여기까지는 내가 스레드를 만들지 않았는데도 멀티코어를 쓰고 있는 셈이다.
이 풀을 쓰는 건 crypto의 일부, fs, zlib, dns.lookup 같은 것들이다. 소켓 같은 네트워크 I/O는 스레드 풀이 아니라 OS의 이벤트 알림(epoll, kqueue)으로 처리하기 때문에 동시 접속이 많아도 스레드가 늘지 않는다.
내 JS를 멀티코어로 돌리려면
방법은 두 가지다.
worker_threads: 같은 프로세스 안에 스레드를 추가한다. fib(40) 10개를 나눠서 돌려봤다.
| 워커 수 | 시간 | 속도 향상 | 스레드 |
|---|---|---|---|
| 없음 | 4784ms | - | 7 |
| 1 | 5082ms | 0.94배 | 8 |
| 2 | 2599ms | 1.84배 | 9 |
| 4 | 1703ms | 2.81배 | 11 |
| 6 | 1411ms | 3.39배 | 13 |
| 10 | 965ms | 4.96배 | 17 |
워커 하나는 작업마다 워커를 새로 만드는 비용 때문에 오히려 느렸다. 그리고 10코어인데도 10배까지는 못 가고 5배에 그쳤다. M5는 10코어 중 6개가 효율 코어라서 전부 같은 속도가 아니고 워커 생성 비용도 있다. (참고로 워커 8개는 6개와 거의 같은 1416ms가 나와서 표에서 뺐다. 한 번씩만 돌린 측정이라 오차도 있다고 봐야 한다.)
cluster: 프로세스 자체를 여러 개 띄워서 같은 포트를 공유한다. fib(40)을 계산하는 서버에 8개 요청을 동시에 보냈다.
| 워커 프로세스 | 8개 요청 처리 시간 | 전체 프로세스 수 |
|---|---|---|
| 1 | 3802ms | 2(주 + 워커 1) |
| 4 | 1145ms | 5(주 + 워커 4) |
요청은 워커 4개에 2개씩 고르게 나뉘었고 각 워커는 스레드를 9개씩 띄워 두고 있었다. 프로세스가 4개면 “내 JS를 실행하는 스레드”도 4개가 된다. 다만 메모리를 공유하지 않으니 세션이나 캐시를 메모리에 두면 워커마다 값이 달라진다. 운영에서는 PM2의 cluster 모드나, 컨테이너를 여러 개 띄우는 방식으로 같은 효과를 낸다고 한다.
React: 코드는 사용자의 브라우저에서 돈다
여기서 착각하기 쉬운 게 있다. React 컴포넌트 코드는 서버의 CPU를 쓰지 않는다(SSR을 제외하면). 빌드 결과물은 정적 파일이고 서버는 그걸 내려줄 뿐이다. 실제 계산은 사용자 기기의 코어가 한다. 그래서 내 맥의 10코어는 의미가 없고 사용자의 저가형 폰이 기준이 된다.
브라우저에서 돌려보니 Node와 구조가 똑같았다. 브라우저의 JS도 메인 스레드 하나에서 돌고 렌더링과 클릭 처리도 같은 스레드를 쓴다. 메인 스레드에서 fib(38)을 돌리는 동안 10ms 타이머를 걸어봤다.
| 상황 | 10ms 타이머가 실제로 실행된 시점 |
|---|---|
| 평상시 | 12ms |
| 메인 스레드 계산 중 | 183ms |
화면으로 치면 183ms 동안 스크롤도 클릭도 먹지 않는다. Web Worker로 옮기면 Node의 워커처럼 코어를 더 쓸 수 있다.
| Worker 수 | 시간(fib(38) 8개) | 속도 향상 |
|---|---|---|
| 없음 | 1382ms | - |
| 2 | 712ms | 1.94배 |
| 4 | 415ms | 3.33배 |
| 8 | 317ms | 4.36배 |
그리고 navigator.hardwareConcurrency로 사용자 기기의 논리 코어 수를 알 수 있다(내 맥은 10).
그렇다면 useTransition 같은 Concurrent 기능은 멀티코어일까? 찾아보니 아니다. 렌더링을 잘게 쪼개서 중간중간 메인 스레드를 양보하는 방식이지, 스레드가 늘어나는 게 아니다. 여기서 Concurrent는 “번갈아 처리한다”는 뜻의 동시성이지, “실제로 동시에 실행한다”는 병렬성이 아니다.
브라우저 자체는 내 코드와 별개로 멀티프로세스다. Chrome은 탭과 사이트별로 렌더러 프로세스를 나누는데 이 글을 쓰는 지금 내 Chrome에는 렌더러 프로세스가 13개 떠 있었다.
개발 서버도 같이 재봤다. 이 블로그(Astro)를 astro dev로 띄우면 Node 프로세스의 스레드가 14개, 빌드 도구인 esbuild 프로세스의 스레드가 16개였다. Go로 만든 esbuild가 왜 빠른지 조금 이해가 됐다.
Python: 스레드를 늘려도 그대로다
Python은 숫자가 제일 충격적이었다. fib(32) 8개를 스레드와 프로세스로 각각 돌렸다.
| 방식 | 실행 시간 | CPU 시간 합계 | 속도 향상 |
|---|---|---|---|
| 순차 실행 | 2.12s | - | - |
| 스레드 2개 | 2.10s | 2.10s | 1.01배 |
| 스레드 4개 | 2.11s | 2.09s | 1.01배 |
| 스레드 8개 | 2.10s | 2.12s | 1.01배 |
| 프로세스 2개 | 1.24s | 2.40s | 1.70배 |
| 프로세스 4개 | 0.74s | 2.91s | 2.87배 |
| 프로세스 8개 | 0.62s | 4.66s | 3.43배 |
스레드를 8개로 늘려도 1.01배다. CPU 시간 합계가 실행 시간과 같으니 코어 하나만큼만 썼다. 범인은 **GIL(Global Interpreter Lock)**이다. CPython에서는 한 프로세스 안에서 한 번에 한 스레드만 Python 바이트코드를 실행할 수 있다. 스레드는 진짜 OS 스레드로 8개가 뜨지만 락을 번갈아 잡을 뿐이다.
프로세스는 각자 GIL을 가지니 진짜 병렬이 된다. 다만 8개로 돌리면 CPU 시간 합계가 2.1초에서 4.66초로 늘었다. 프로세스를 띄우는 비용과 느린 효율 코어까지 쓰게 된 영향으로 보인다.
재밌는 건 프로세스 4개를 요청했을 때 자식 프로세스가 5개였다는 점이다. 확인해보니 나머지 하나는 multiprocessing.resource_tracker라는 관리용 프로세스였다.
그럼 스레드는 쓸모없나
그렇지 않다. 기다리는 일은 다르다. sleep(0.5) 8개로 I/O 대기를 흉내 내봤다.
| 방식 | 시간 | 스레드 |
|---|---|---|
| 순차 실행 | 4.03s | 1 |
| 스레드 8개 | 0.52s | 9 |
| asyncio | 0.50s | 1 |
I/O를 기다리는 동안에는 GIL을 놓기 때문에 스레드가 잘 먹힌다. asyncio는 스레드 하나로 같은 결과를 냈는데 이건 구조상 Node의 이벤트 루프와 같다. Node를 먼저 해서 그런지 asyncio는 이해가 쉬웠다.
정리하면 Python에서는 이렇게 고른다.
- 순수 Python 계산이 많다 →
multiprocessing,ProcessPoolExecutor - 기다림이 많고 라이브러리가 async를 지원한다 →
asyncio - 기다림이 많고 동기 라이브러리를 써야 한다 →
threading
웹 서버도 같은 이유로 프로세스 단위로 늘린다. gunicorn이나 uvicorn은 --workers 옵션으로 프로세스 수를 정하는데 기본값이 1이다. 그냥 띄우면 Python 코드를 실행하는 코어는 사실상 하나뿐이다.
참고로 NumPy 같은 C 확장은 계산 중에 GIL을 놓는 경우가 많아서 스레드로도 병렬이 된다고 한다. 뒤에 나오는 이미지 변환에서 실제로 그런 결과를 봤다. 그리고 GIL을 없앤 free-threaded 빌드가 Python 3.13에서 실험적으로 들어왔고 3.14에서 공식 지원으로 올라갔다. 내 맥의 Python은 3.9라 아직 못 돌려봤는데 다음에 같은 실험을 해보고 싶다.
Spring Boot: 처음부터 멀티코어
Spring Boot는 앞의 것들과 출발점이 다르다. 이번에는 JDK 25와 Spring Boot 4.1.2로 프로젝트를 만들어 똑같이 재봤다. /ping, /block처럼 앞에서와 같은 엔드포인트를 두고 JIT가 코드를 최적화할 수 있게 몇 번 호출한 뒤에 측정했다.
띄우기만 해도 48개
요청을 하나도 보내지 않았는데 스레드가 48개였다. jstack으로 보면 이름이 나온다.
| 스레드 | 개수 | 역할 |
|---|---|---|
http-nio-*-exec-* | 10 | 요청을 처리하는 Tomcat 워커 |
http-nio-*-Acceptor/Poller | 2 | 연결 수락, 소켓 이벤트 감시 |
GC Thread#* 등 G1 관련 | 14 | 가비지 컬렉션 |
C1/C2 CompilerThread* | 4 | JIT 컴파일(개수가 변한다) |
| 그 외 JVM, Spring 내부 | 나머지 | 시그널, 참조 처리 등 |
Tomcat 워커는 10개뿐이고 나머지는 JVM이 돌아가기 위해 쓰는 스레드다. 물론 대부분은 평소에 자고 있다.
JVM은 이 숫자를 코어 수에 맞춰 정한다. -XX:ActiveProcessorCount=2로 “코어가 2개”라고 알려주니 GC 스레드가 9개에서 2개로, 컴파일러 스레드가 4개에서 2개로 줄어 전체가 38개가 됐다. 반면 Tomcat 워커는 10개 그대로였다.
막히지 않는다
Node에서 1811ms를 기다렸던 실험을 그대로 했다. /block은 fib(44)를 돌려서 1초쯤 걸린다.
| 설정 | /block 처리 중 /ping 응답 시간 |
|---|---|
| 기본값 | 1ms |
| 워커를 1개로 제한 | 651ms |
요청마다 다른 스레드가 처리하니 /ping은 전혀 영향을 받지 않았다. 재밌는 건 server.tomcat.threads.max=1로 워커를 하나로 줄이면 Node와 똑같이 기다린다는 점이다. Node 자체의 속도는 상관없고 일하는 스레드 수가 응답 시간을 갈랐다는 걸 확실히 보여주는 결과였다.
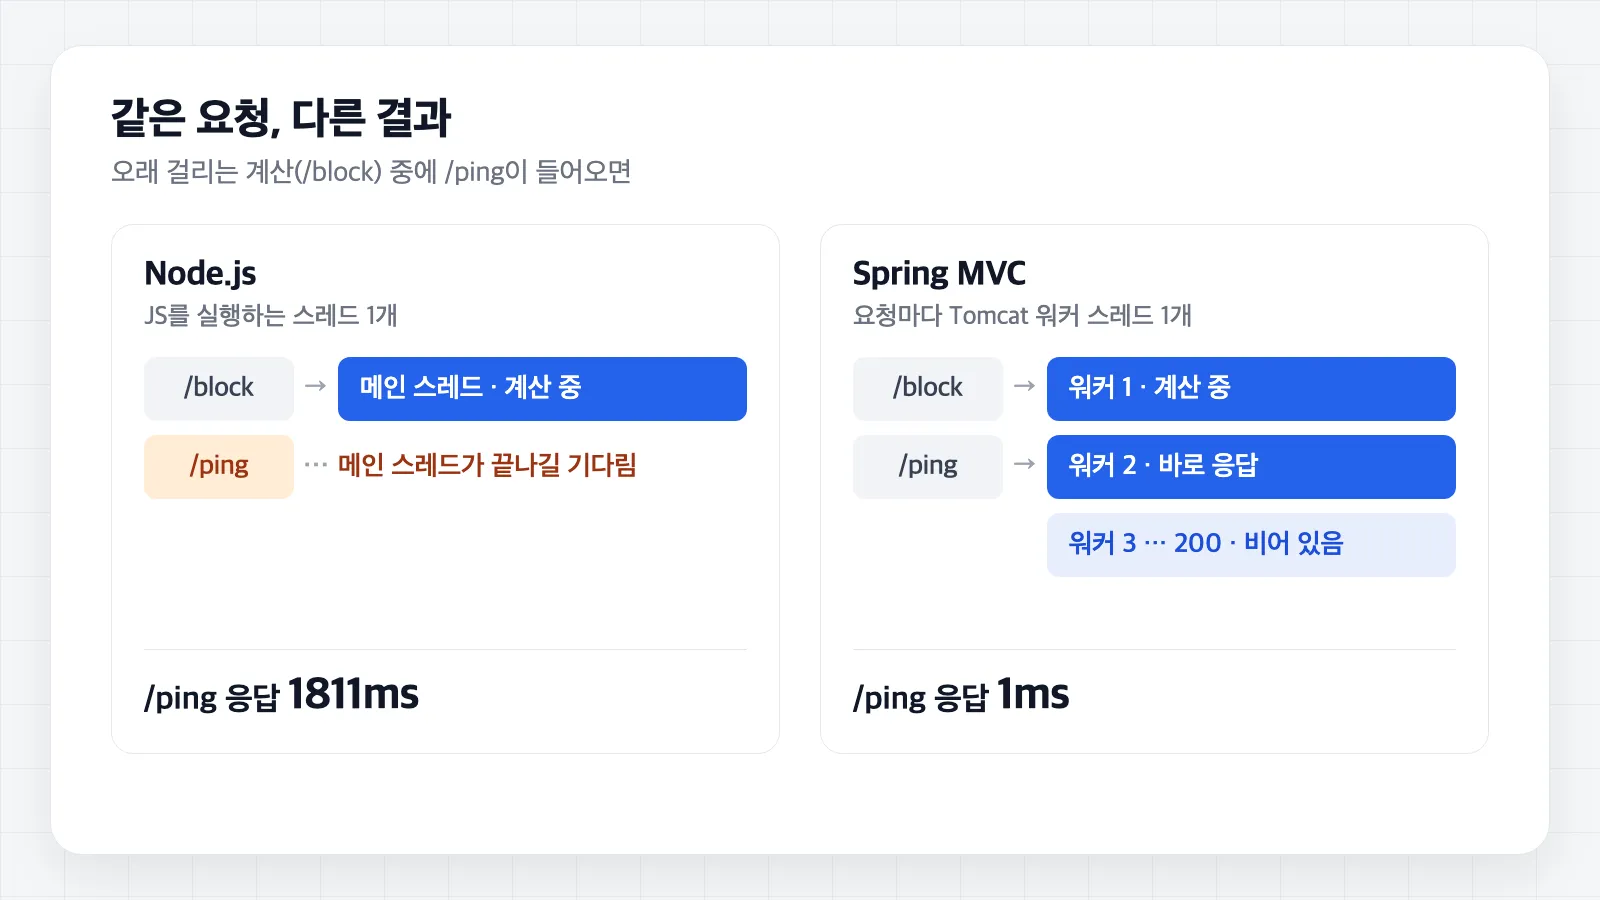
/block은 Node에서 fib(43), Spring에서 fib(44)로 조금 다르다
/block을 동시에 보내면 코어를 얼마나 쓰는지도 재봤다. “평균 코어”는 CPU 시간을 실행 시간으로 나눈 값이다.
| 동시 요청 | 시간 | 평균 코어 |
|---|---|---|
| 1 | 0.96s | 1.00 |
| 2 | 0.99s | 1.99 |
| 4 | 1.05s | 3.97 |
| 8 | 1.48s | 7.68 |
| 10 | 1.74s | 8.74 |
| 20 | 3.48s | 9.06 |
스레드 코드를 한 줄도 안 썼는데 요청 수만큼 코어를 쓴다. 4개까지는 성능 코어에서 거의 1초를 유지하고 그 뒤로는 효율 코어까지 쓰면서 조금씩 느려진다. 워커를 1개로 제한하면 8개 요청에 7.76초, 평균 코어 1.00이 나온다. 기본값의 1.48초와 비교하면 5배 넘게 차이가 난다.
스레드는 200개에서 멈춘다
Tomcat 워커의 기본 최댓값은 200개다. 1초 동안 자기만 하는 요청을 보내봤다.
| 설정 | 동시 요청 | 시간 | 최대 스레드 |
|---|---|---|---|
| 기본값 | 300 | 2.05s | 237 |
| 기본값 | 2000 | 10.15s | 238 |
| 가상 스레드 | 2000 | 1.13s | 50 |
2000개를 200개씩 처리하니 정확히 10초가 걸렸고 그동안 CPU는 0.2코어만 썼다. 코어는 남아도는데 스레드가 모자라서 기다린 것이다.
spring.threads.virtual.enabled=true로 Java 21의 가상 스레드를 켜면 2000개가 1.13초에 끝나고 OS 스레드는 50개면 된다. 자는 동안 OS 스레드를 놓아주기 때문이다. 다만 CPU 작업은 빨라지지 않았다. /block 20개는 기본값이 3.48초, 가상 스레드가 3.59초로 거의 같았다. 코어 수는 그대로니까.
커넥션 풀이라는 또 다른 병목
Tomcat 스레드는 200개까지 늘어나는데 HikariCP의 DB 커넥션은 기본 10개다. 커넥션을 500ms 잡고 있는 요청 40개를 보냈다.
| 커넥션 풀 | 시간 |
|---|---|
| 10(기본값) | 2.03s |
| 40 | 0.52s |
10개씩 4번 처리하니 2초다. 스레드가 충분해도 커넥션을 기다리면 소용이 없다. 그렇다고 무작정 늘리면 부담이 DB로 넘어가니, 스레드 수든 커넥션 수든 숫자 하나만 키운다고 해결되지는 않는 것 같다.
WebFlux는 Node에 가깝다
같은 Spring이어도 WebFlux는 다르다. Netty의 이벤트 루프 스레드 reactor-http-nio-*가 코어 수와 같은 10개까지 늘어났고 처음 36개였던 전체 스레드는 요청을 받고 나서 45개가 됐다.
구조가 Node와 비슷하다 보니 약점도 비슷했다. 이벤트 루프에서 fib(44)를 10개 돌리는 동안 /ping을 보냈더니 1372ms를 기다렸다. MVC에서는 1ms였던 요청이다. Node와 다른 점은 이벤트 루프가 코어 수만큼 있어서 8개를 동시에 돌렸을 때 평균 7.5코어를 썼다는 것이다. 멀티코어는 쓰지만 이벤트 루프를 막으면 안 된다는 규칙은 똑같다.
그 외에 스프링 빈이 기본적으로 싱글톤이라 필드에 상태를 두면 안 된다는 말도 이제야 이해했다. 스레드 여러 개가 같은 객체를 동시에 쓰기 때문이다. Node에서는 JS를 스레드 하나가 실행하니 크게 신경 쓰지 않았던 문제다.
실전: tif를 png로 바꾸면 코어를 얼마나 쓸까
여기까지는 피보나치라는 인위적인 작업이었다. 실제로 CPU를 많이 먹었던 기억을 떠올려보면 이미지 처리, 특히 tif를 png로 변환할 때였다. 그래서 직접 재봤다.
4000×3000, 무압축 36MB짜리 tif를 노이즈로 만들어 썼다. 노이즈는 압축이 잘 안 되는 편이라 실제 사진과는 시간이 다를 수 있다. Node는 sharp 0.34.5, Spring은 Java 기본 ImageIO를 썼다.
// Node
await sharp('test.tif').png().toBuffer();
// Spring
var img = ImageIO.read(new File(path));
ImageIO.write(img, "png", out);| 동시 변환 | sharp 기본 | sharp UV_THREADPOOL_SIZE=8 | Spring ImageIO |
|---|---|---|---|
| 1 | 0.39s / 1.03코어 | 0.41s / 1.02코어 | 1.07s / 0.95코어 |
| 2 | 0.41s / 2.07코어 | 0.41s / 2.05코어 | 0.94s / 2.00코어 |
| 4 | 0.45s / 4.07코어 | 0.45s / 4.11코어 | 1.11s / 3.85코어 |
| 8 | 0.89s / 4.10코어 | 0.61s / 7.59코어 | 1.61s / 7.54코어 |
표를 보면서 알게 된 게 몇 가지 있다.
한 장을 변환할 때는 코어 하나만 꽉 쓴다. sharp는 멀티스레드로 유명한데도 1.03코어였다. sharp.concurrency()를 1로 바꿔도 시간이 똑같았다. 어디가 오래 걸리는지 궁금해서 출력 형식과 스레드 수를 바꿔봤다.
| 작업 | concurrency=1 | concurrency=10 |
|---|---|---|
| png 변환 | 0.42s / 1.01코어 | 0.41s / 1.02코어 |
| 블러 후 raw 출력 | 0.13s / 1.01코어 | 0.03s / 6.04코어 |
| 블러 후 png 변환 | 0.30s / 1.38코어 | 0.31s / 1.65코어 |
블러 같은 픽셀 연산은 6코어까지 쓰면서 4배 넘게 빨라졌다. 그런데 뒤에 png 출력이 붙으면 효과가 사라진다. 이 측정에서는 png 인코딩이 한 코어에 묶인 병목이었다. 코어를 늘린다고 tif → png 한 장이 빨라지지는 않는다.
Node는 4개에서 막힌다. sharp는 앞에서 본 libuv 스레드 풀 위에서 돈다. 8장을 동시에 줘도 4코어만 쓰다가 UV_THREADPOOL_SIZE=8로 늘리니 7.59코어를 썼다. 그리고 변환 중에도 이벤트 루프 지연은 최대 12ms였다. JS로 계산했다면 서버가 멈췄을 텐데, 일을 스레드 풀로 넘기니 다른 요청을 계속 받을 수 있다. 무거운 일은 네이티브 라이브러리에 맡기라는 말의 의미를 알 것 같다.
Spring은 요청 수만큼 코어를 쓴다. 변환 중에도 /ping은 1ms였다. 대신 제한이 없다. 워커가 200개니 이미지가 200개 동시에 들어오면 200개를 전부 돌리려 할 것이다. 이 이미지는 디코딩하면 한 장에 픽셀만 36MB이므로 계산상 7GB가 넘는다. 이 상황까지 재보지는 않았지만 Semaphore나 별도 스레드 풀, 작업 큐로 동시 변환 수를 제한해야 할 것 같다.
결국 CPU를 많이 쓰는 이유는 단순했다. 픽셀이 많고 그 전부를 압축하느라 코어 하나를 쉬지 않고 쓴다. 기다리는 시간이 없는 작업이라, 앞에서 본 가상 스레드나 asyncio 같은 “기다림을 줄이는” 방법은 도움이 안 된다. 동시에 처리할 양을 코어 수에 맞춰 조절하는 게 답이다. 라즈베리파이 홈서버(4코어)에 올린다면 더 신경 써야 할 부분이다.
Python은 어떨까: 이번엔 스레드가 먹힌다
Python에서는 Pillow(11.3.0)로 같은 이미지를 변환했다. 앞에서 스레드 8개로 1.01배가 나왔으니 이번에도 프로세스를 써야 할 줄 알았다.
with Image.open('test.tif') as im:
im.save(buf, 'PNG')| 동시 변환 | 스레드 | 프로세스 |
|---|---|---|
| 1 | 0.44s / 0.99코어 | 0.58s / 0.99코어 |
| 2 | 0.44s / 1.98코어 | 0.58s / 1.98코어 |
| 4 | 0.49s / 3.93코어 | 0.66s / 3.90코어 |
| 8 | 0.71s / 7.24코어 | 0.87s / 7.61코어 |
예상이 틀렸다. 스레드만으로 7코어 넘게 썼다. 8장을 처리하는 데 0.71초면, 순서대로 했을 때의 약 3.5초보다 5배 가까이 빠르다. 피보나치에서는 꼼짝도 않던 스레드가 여기서는 멀쩡히 병렬로 돈다.
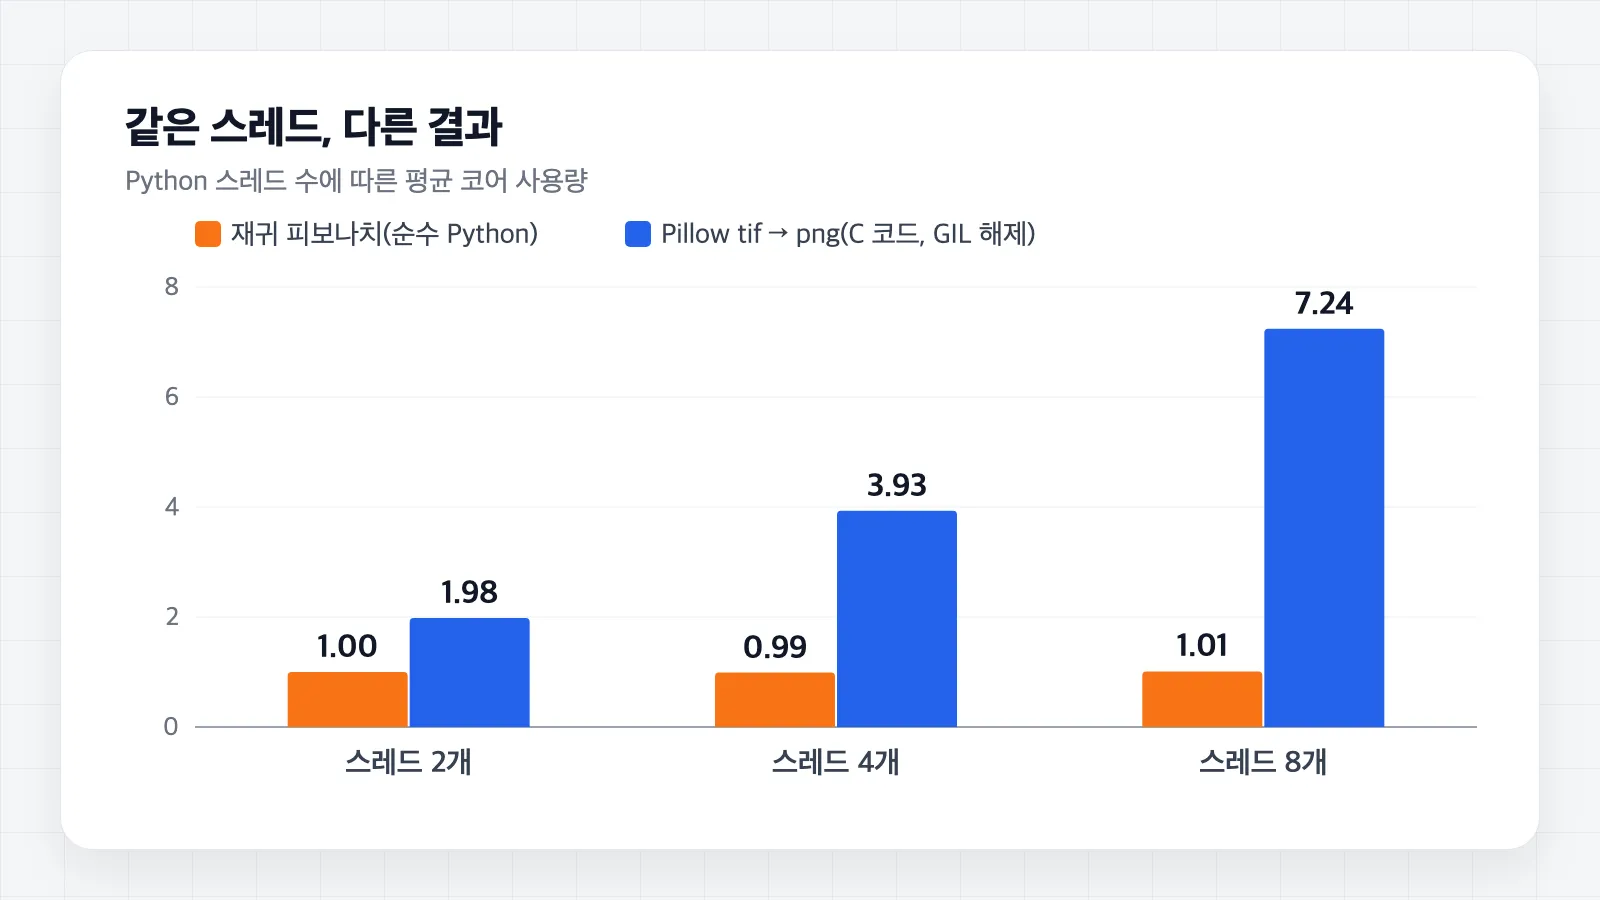 같은 Python 스레드인데 하는 일에 따라 쓰는 코어 수가 달라진다
이유는 GIL이 막는 대상이 Python 바이트코드이기 때문이다. Pillow의 인코딩은 C 코드에서 돌고 그동안 GIL을 놓는다. 변환 중에 10ms마다 깨어나는 Python 스레드를 같이 돌려봤는데 지연이 최대 3ms에 그쳐서 GIL이 잡혀 있지 않다는 걸 확인할 수 있었다.
오히려 프로세스가 스레드보다 조금 느렸다. 이 실험은 결과로 숫자 하나만 돌려받았으니 차이는 대부분 프로세스를 새로 띄우는 비용으로 보인다. 변환된 이미지를 그대로 돌려받는다면 복사 비용까지 더해질 것이다. 그래서 앞에서 정리한 “계산이 많으면 프로세스”에는 조건이 붙는다. 순수 Python으로 계산할 때 프로세스이고 C 라이브러리가 일하는 동안 GIL을 놓는다면 스레드로 충분하다.
한눈에 비교
| 환경 | 프로세스(기본) | 내 코드를 실행하는 스레드 | 기본으로 멀티코어를 쓰나 | 늘리는 방법 |
|---|---|---|---|---|
| React(브라우저) | 탭/사이트별 | 1(메인) | 내 코드는 아니다 | Web Worker |
| Node.js | 1 | 1(이벤트 루프) | 내 JS는 아니다(풀은 쓴다) | worker_threads, cluster |
| Python | 1 | GIL로 한 번에 1 | 아니다 | multiprocessing, 워커 프로세스 |
| Spring Boot(MVC) | 1 | 요청당 1(최대 200) | 그렇다 | 기본으로 동작 |
배운 점
처음의 질문으로 돌아가면, “내 코드가 코어를 몇 개 쓰는가”의 답은 언어가 아니라 그 순간 일하고 있는 스레드 수로 정해진다는 걸 알게 됐다.
그리고 스레드와 코어를 늘리는 게 의미 있으려면 내 서버가 뭘 하느라 바쁜지부터 알아야 한다. 웹 서버는 대부분 DB나 외부 API를 기다리는 시간이 길다. 기다리는 일이 많다면 코어보다 이벤트 루프나 커넥션 풀이 문제가 되고, 계산이 많다면 그제서야 코어가 문제가 된다. 싱글 스레드라던 Node가 웹 서버로 잘 쓰이는 이유도, Python의 GIL이 웹 서버에서 생각만큼 치명적이지 않은 이유도 여기에 있었다.
이미지 변환을 재보고 나서는 생각이 하나 더 늘었다. 스레드를 아무리 늘려도 작업 자체가 한 코어에 묶여 있으면 소용이 없다. 그래서 숫자를 키우기 전에 어디가 병목인지부터 재봐야 한다.
다음에는 라즈베리파이 홈서버의 Docker 컨테이너에서 CPU 제한을 걸면 이 숫자들이 어떻게 바뀌는지 확인해보고 싶다.